Projekte · Datenplattform
Selbst gehostete Datenplattform
Ein privates System, das erfasst, was ich esse, wie ich mich fühle, was ich tue, wie meine Vitalwerte aussehen und wie die Luft in dem Raum ist, in dem ich sitze. Alles läuft über eine eigene API in eine eigene Datenbank auf Servern, die ich selbst betreibe. Entstanden ist eine durchgehende Datenstrecke von der Erfassung über die Aufbereitung bis zum Modell, die seit einem Jahr ohne Unterbrechung läuft.
- Rolle
- Konzept, Entwicklung und Betrieb, allein
- Zeitraum
- laufend seit September 2025
- Stack
- Django, REST-API, Flutter, ESP32 mit BME680, NFC, Google Health API, MySQL, FullCalendar, Apache Airflow, TensorFlow, scikit-learn, Proxmox, Ubuntu Server
- Code
- Repository und README auf Anfrage, siehe Kontakt
Das System auf einen Blick
Sechs Quellen, eine Schnittstelle, drei virtuelle Maschinen. Zwei Flutter Apps, die Sensorik in den Räumen, die NFC-Tags an den Türen, meine Fitbit und ein Formular im Browser liefern alle an dieselbe Django Anwendung. Sie schreibt in einen MySQL-Server auf einer zweiten Maschine und liest von dort auch wieder, um die Auswertungen anzuzeigen. Auf einer dritten Maschine räumt Apache Airflow die Rohdaten auf und legt daraus einen Datensatz ab, mit dem sich unmittelbar trainieren lässt.
Django als Drehscheibe
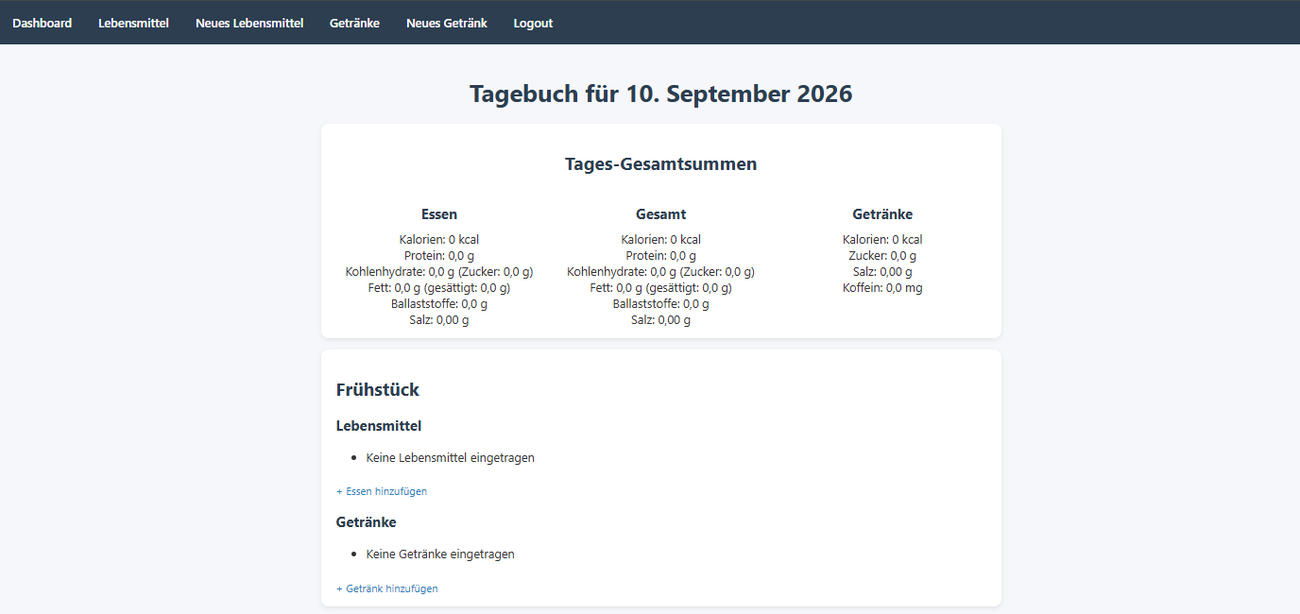
Die Django Anwendung hat zwei Aufgaben. Nach außen ist sie eine Weboberfläche, in der ich Mahlzeiten und Getränke erfasse und die Auswertungen ansehe. Nach innen ist sie die REST-Schnittstelle, an die alle anderen Quellen liefern.
Lebensmittel und Getränke liegen mit ihren Nährwerten in der Datenbank. Bei der Eingabe rechnet die Anwendung anhand der Menge in Gramm oder Millilitern um, ordnet das Ergebnis der Mahlzeit zu und summiert es über den Tag zu Kalorien, Protein, Kohlenhydraten mit Zuckeranteil, Fett mit gesättigtem Anteil, Ballaststoffen, Salz und bei Getränken zusätzlich Koffein.
Zwei Apps für das, was kein Sensor misst
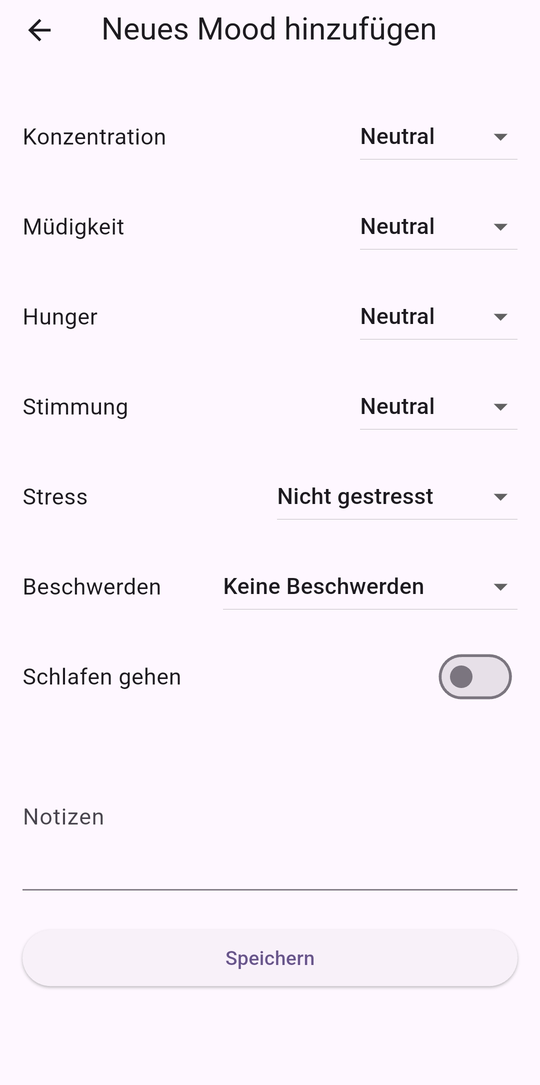
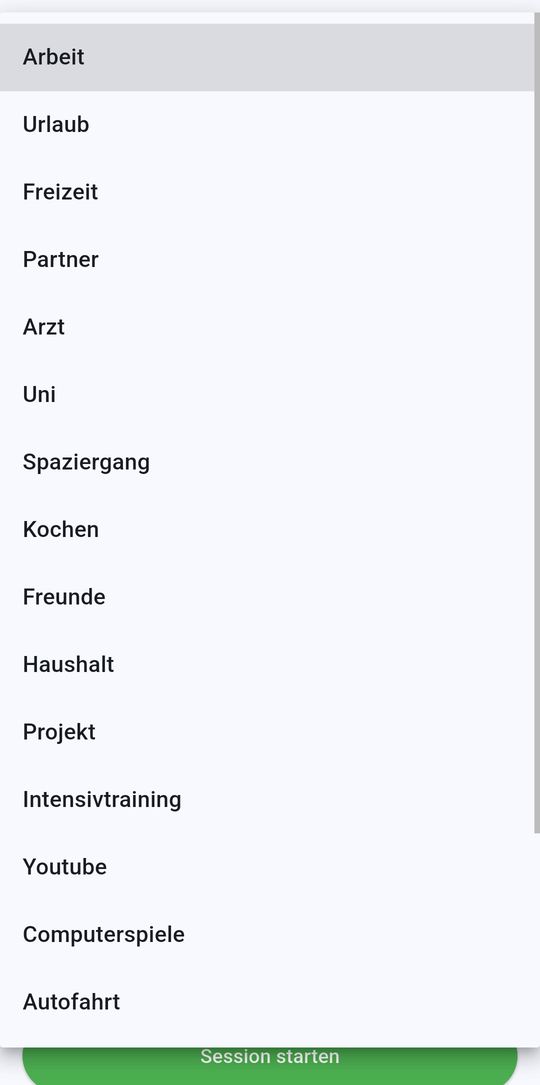
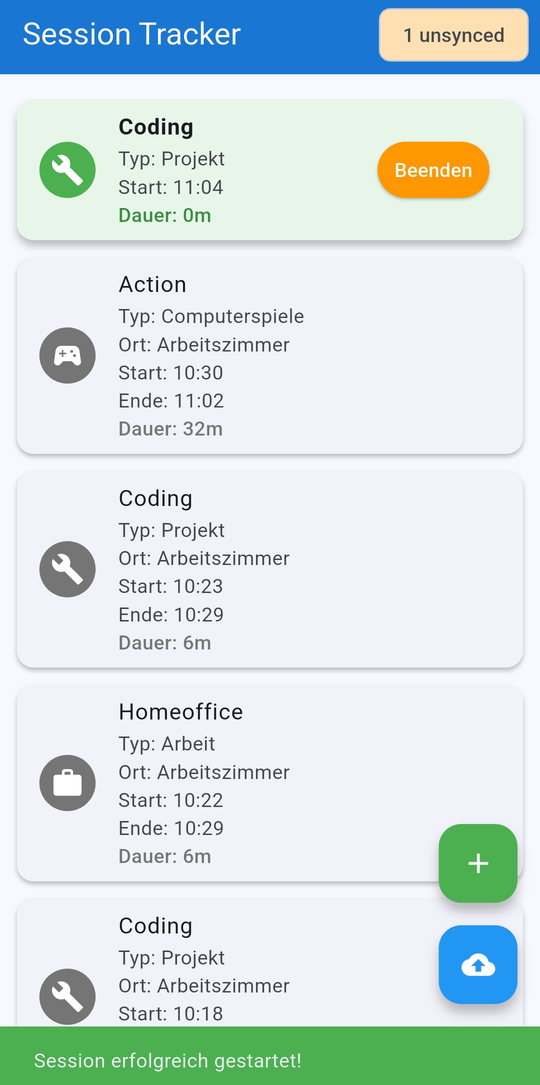
Stimmung und Aktivitäten kann kein Gerät automatisch erheben, also habe ich zwei Flutter Apps für Android gebaut. Eine erfasst Konzentration, Müdigkeit, Hunger, Stimmung, Stress und Beschwerden, die andere läuft als Stoppuhr für Aktivitäten mit Typ, Start und Ende. Beide halten die Eingabe bewusst kurz, weil eine Tracking-App, die eine Minute Aufmerksamkeit kostet, nach zwei Wochen nicht mehr benutzt wird.
Gesendet wird an die Schnittstelle, sobald das Handy im lokalen Netz ist. Bis dahin liegen die Einträge lokal in der App, der Zähler in der Kopfzeile zeigt die offenen an, und ein Tippen schickt sie nach. Ohne diesen Puffer wäre jeder Eintrag außer Haus verloren.
Was daraus im Browser wird
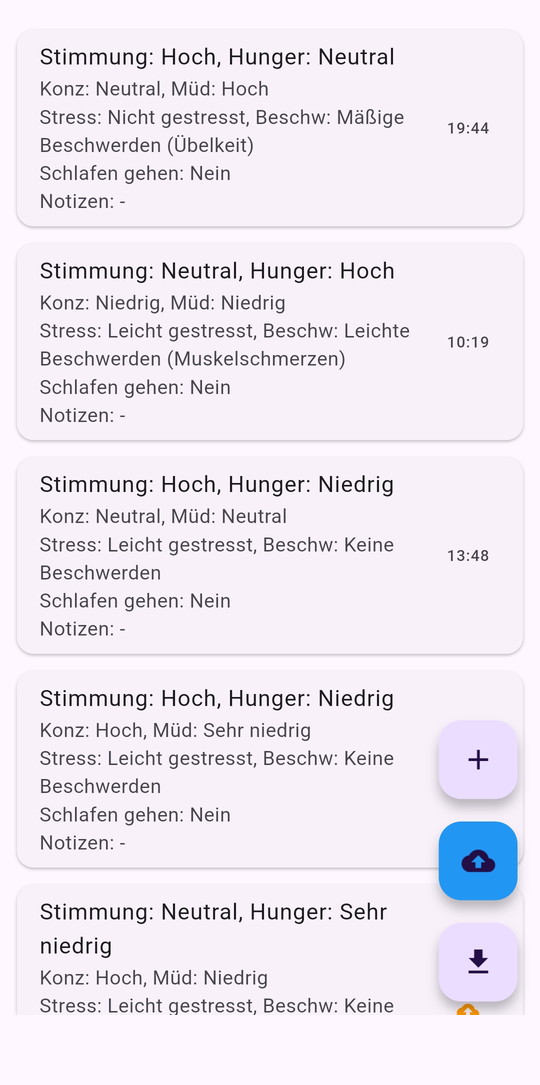
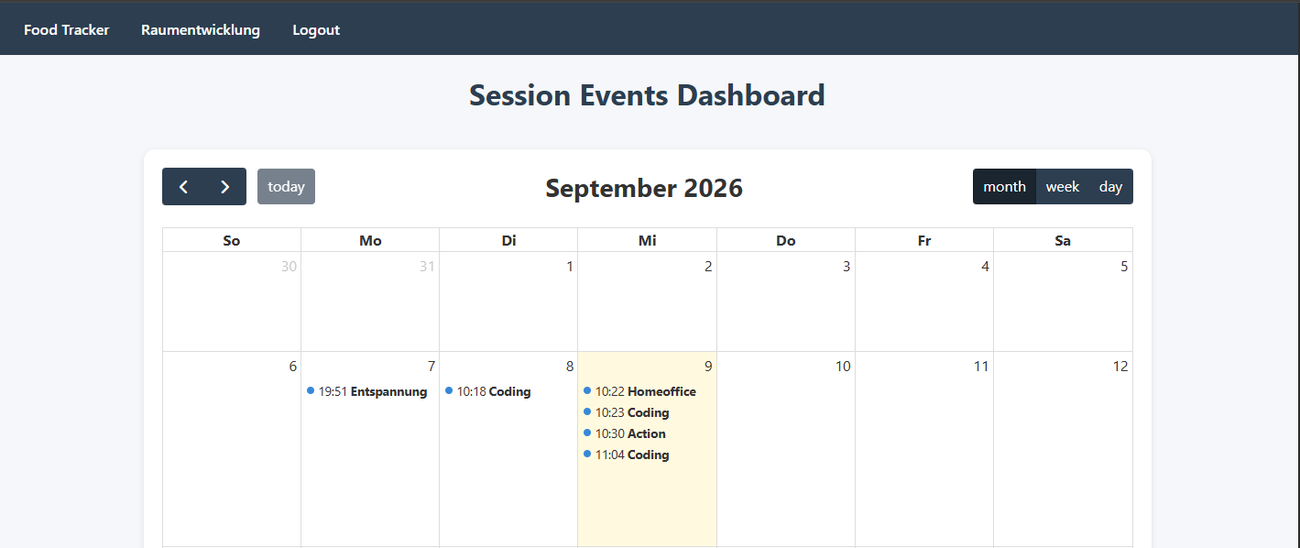
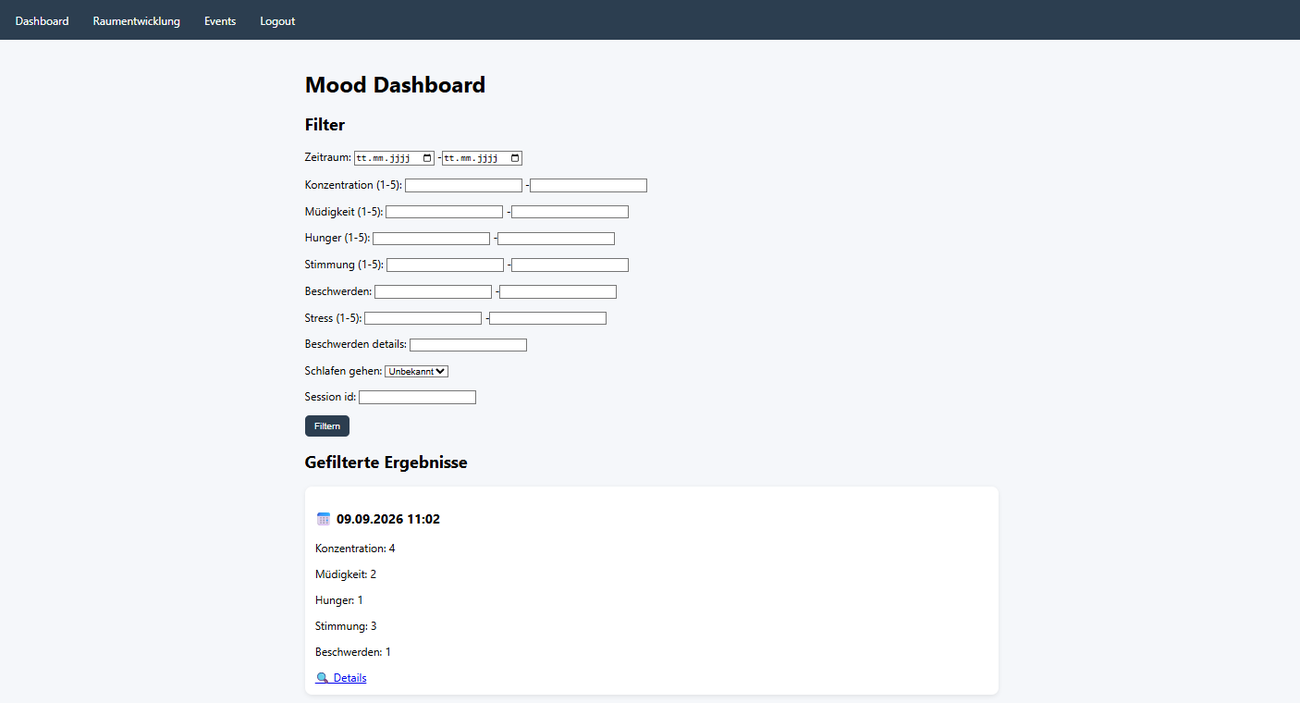
Beide Apps schreiben in dieselbe Datenbank, aus der die Django-Anwendung ihre Ansichten baut. Die Aktivitäten laufen als Termine in einen FullCalendar, die Stimmungseinträge in eine Übersicht, die sich nach Zeitraum, nach Wertebereich je Merkmal, nach Beschwerden und nach Sitzung filtern lässt.
Sensorik und NFC
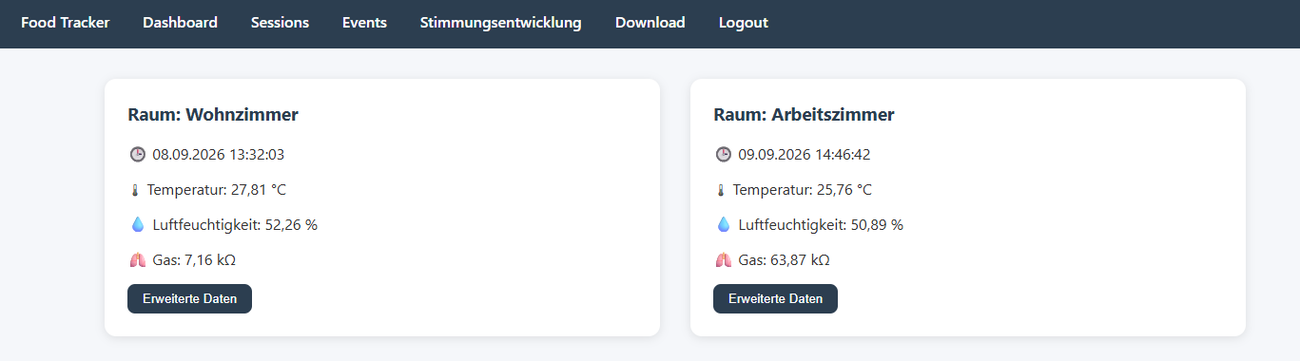
In den Räumen hängen ESP32 Boards mit BME680-Sensoren. Vier Leitungen, Strom und I²C, mehr braucht der Aufbau nicht. Das Board liest Temperatur, Luftfeuchte, Luftdruck und Luftqualität aus und schickt sie über das eigene WLAN an dieselbe API wie alles andere.
Damit die Messwerte einen Bezug zu mir bekommen, klebt an jeder Tür ein NFC-Tag. Einmal mit dem Handy dranhalten, und ein Aufruf der Schnittstelle startet die Sitzung für diesen Raum. So weiß das System nicht nur, wie die Luft war, sondern auch, ob ich darin war.
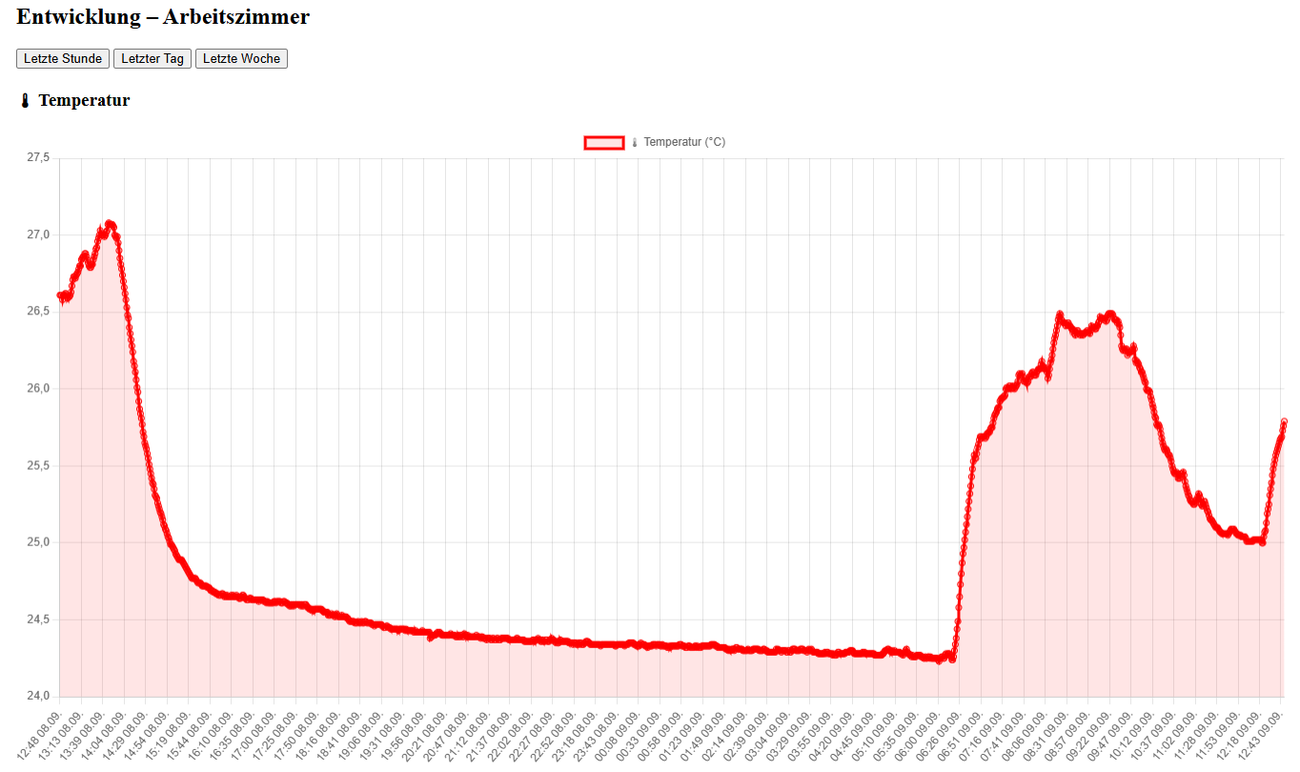
In der Anwendung liegt für jeden Raum der letzte Messwert und darunter der Verlauf. Die Kurve zeigt, was der Aufbau leistet. Der Abfall am Abend, die flache Nacht und der steile Anstieg am Morgen sind keine Messfehler, sondern ein geöffnetes Fenster, ein auskühlender Raum und ein Arbeitstag, der beginnt.
Vitaldaten über die Google Health API
Herzfrequenz, Schritte, Schlaf und Aktivitäten kommen von einer Fitbit Inspire 3. Der Import lief ursprünglich über die Fitbit Web API und ist auf die Google Health API umgezogen, nachdem die alte Schnittstelle abgekündigt wurde. Geholt wird planmäßig, damit die Zeitreihen lückenlos bleiben. Der folgende Lauf ist so ein Datensatz, ausgewertet auf dem eigenen Server.
Aufbereitung mit Apache Airflow
Sechs Quellen heißen sechs Formate, sechs Zeitauflösungen und sechs Arten, unvollständig zu sein. Der Sensor misst im Sekundentakt, die Fitbit liefert Tagesaggregate, eine Mahlzeit hat einen Zeitpunkt, eine Session einen Zeitraum. Airflow-DAGs bereinigen die Rohdaten, gleichen die Zeitstempel an, markieren Lücken und führen alles in ein gemeinsames Datenmodell zusammen. Am Ende jedes Laufs liegt ein Datensatz bereit, mit dem sich direkt trainieren lässt.
Der Punkt daran ist Wiederholbarkeit. Ein Notebook, das einmal funktioniert hat, ist keine Pipeline. Ein DAG, der jeden Tag durchläuft und bei einem Fehler an genau einer Stelle stehen bleibt, schon.
Betrieb auf eigenem Hypervisor
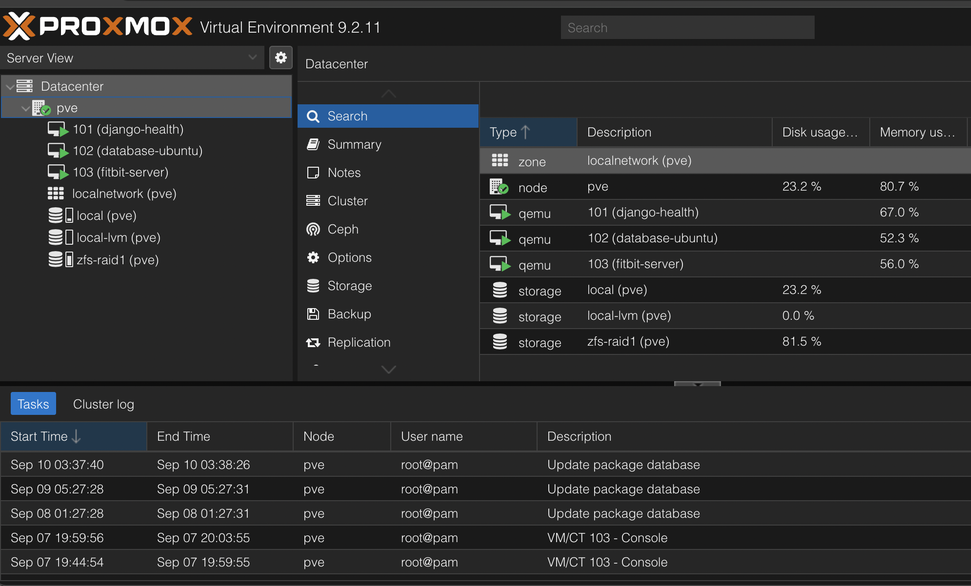
Die Plattform läuft auf einem Proxmox Hypervisor bei mir zu Hause, aufgeteilt auf drei getrennte Maschinen mit Ubuntu Server. Eine trägt die Django Anwendung, eine die MySQL Datenbanken, eine den Fitbit-Import und die Analyseumgebung. Virtualisierung, Netzwerk, Nutzerrechte, Backups und Updates liegen damit genauso bei mir wie der Code.
Die Trennung ist Absicht. Ein fehlgeschlagenes Update in der Analyseumgebung darf die API nicht mitreißen, und eine Datenbank, die auf einer eigenen VM liegt, lässt sich unabhängig sichern und zurückspielen. Als Speicher liegt darunter ein ZFS-Pool, Updates und Backups laufen als wiederkehrende Aufgaben. Jede weitere Anwendung bekommt dasselbe Muster aus eigener Maschine und eigener Datenbank.
Was dabei herauskommt
Am Ende der Kette steht die Auswertung. In einer Anaconda-Umgebung arbeite ich mit TensorFlow und scikit-learn auf dem zusammengeführten Datensatz und gehe Zusammenhängen nach, die ohne durchgehende Messung unsichtbar bleiben. Dazu gehört, ob sich Sport am Vortag in der Stimmung niederschlägt, ob die Konzentration mit der Luftqualität im Arbeitszimmer nachlässt und ob spätes Essen den Schlaf verändert. Veranschaulicht durch eine Korrelationsmatrix über alle Merkmale. Sie zeigt, wo sich überhaupt etwas abzeichnet, und entscheidet darüber, welche Größen in ein Modell wandern.
Was ich daraus mitgenommen habe
Der aufwendigste Teil war nicht das Modell, sondern alles davor. Zeitstempel über sechs Quellen hinweg vergleichbar zu machen, Ausfälle einer Sensoreinheit sauber zu behandeln und eine API so zu schneiden, dass eine neue Quelle keine Migration im Bestand auslöst, hat mehr Zeit gekostet als das Training.
Genauso wichtig war die Einsicht, dass Erfassung nur überlebt, wenn sie nichts kostet. Alles, was mehr als ein paar Sekunden Aufmerksamkeit verlangt hätte, ist entweder automatisiert worden oder aus dem System geflogen.
Quellcode und Dokumentation stelle ich auf Anfrage zur Verfügung, ebenso weitergehende Auskunft zum Aufbau. Die Kontaktangaben stehen auf der Startseite.