Projekte · Bachelorthesis
KI-gestützte Roboter-Manipulationspipeline
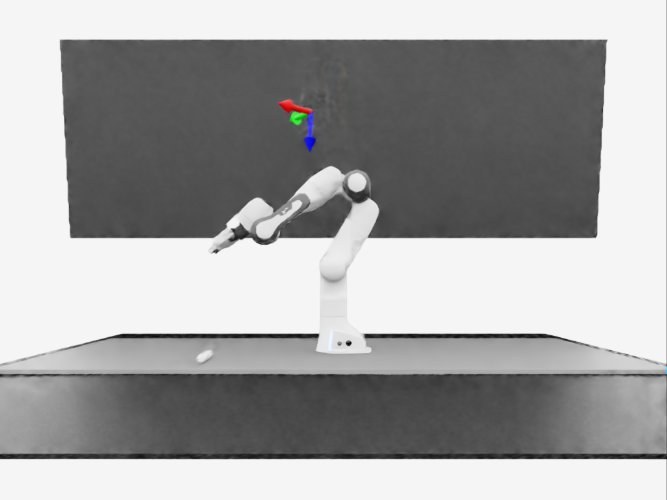
Ein Roboterarm greift ein chirurgisch nachempfundenes Instrument, hebt es an und legt es an einer Zielpose ab, gelernt allein in der Simulation. Ein zweites Modell liest aus dem Kamerabild ab, ob das Instrument gerade getragen wird. Die eigentliche Frage der Arbeit war nicht, ob beides funktioniert, sondern was passiert, wenn die Bedingungen nicht mehr die des Trainings sind.
- Rolle
- Bachelorarbeit, Einzelarbeit
- Betreuung
- Prof. Dr. Martin Prause, AKAD University Stuttgart
- Stand
- eingereicht 08/2026, Bewertung ausstehend
- Umfang
- eine Greifpolicy, zehn Segmentierungsmodelle, drei synthetische Datensätze mit je 2.800 Bildern
- Stack
- Fusion 360, NVIDIA Isaac Sim, Isaac Lab, Replicator, rsl_rl, PPO, U-Net, Python
- Unterlagen
- Arbeit und Code auf Anfrage, siehe Kontakt
Vorgehen
Modellieren
- Fusion 360
- chirurgischer Meißel
- USD · SDF-Kollider
Greifen lernen
- Isaac Lab · Franka Panda
- rsl_rl · PPO
- 4.096 Umgebungen
Daten erzeugen
- Aufnahme im Greifzyklus
- Domain Randomization
- 3 × 2.800 Bilder
Segmentieren
- U-Net · 4 Klassen
- 2 Stufen × 5 Startwerte
Zusammenführen
- Greifzustand aus der Maske
- Abgleich mit der Physik
Grundlage ist die Isaac-Lab-Beispielumgebung Isaac-Lift-Cube-Franka-v0,
die ich für den Anwendungsfall erweitert habe. Statt eines Würfels greift der Arm
ein selbst in Fusion 360 konstruiertes Instrument, statt reinem Anheben verlangt die
Aufgabe ein Halten auf geforderter Zielhöhe, dazu kommen angepasste Belohnungs-,
Beobachtungs- und Abbruchstrukturen.
Das Objekt wiegt 0,15 kg und bekommt einen SDF-basierten Kollider, der die kantige Form punktgenau nachzeichnet. Mit einfachen Box-Kollidern rutschte das Werkzeug regelmäßig aus dem Greifer, das war keine Feinheit, sondern der Unterschied zwischen lernbar und nicht lernbar.
Greifen lernen
Trainiert wurde mit PPO über rsl_rl, mit 4.096 parallelen Umgebungen auf einer RTX 3060 und rund 13.000 Iterationen. Ein Signal nur für den erfolgreichen Abschluss wäre viel zu selten, deshalb ist die Belohnung in Teilterme für Annähern, Greifen, Anheben, Transportieren und Ablegen zerlegt. Die Terme für das präzise Ablegen konkurrieren allerdings mit denen für das Anheben. Von Beginn an aktiv, konvergierte das Training nicht, erst das Zuschalten nach 9.000 Iterationen als Curriculum stabilisierte es.
Der größere Teil der Arbeit steckte im Schließen von Schlupflöchern. Sich selbst überlassen, fand der Agent Abkürzungen, die den Erfolgsterm formal erfüllten. Er balancierte das Werkzeug auf dem Unterarm, statt es im Greifer zu halten, oder der Arm sackte während der Annäherung in sich zusammen. Beides habe ich über zusätzliche Bedingungen im Belohnungsentwurf ausgeschlossen.
Bewertet wurde die fertige Policy auf drei Testszenarien, die sich einzig im erlaubten Bereich der Objektstartpose unterscheiden, nämlich dem Trainingsbereich, einer Erweiterung um 30 Prozent und einer um 60 Prozent. Die Erfolgsrate zählt nur Durchläufe, in denen das Objekt gegriffen, angehoben, transportiert und an der Zielpose abgelegt wurde.
Der Abfall verläuft kontinuierlich und leicht beschleunigt, die zweite Erweiterungsstufe kostet etwa das 1,7-fache der ersten. Einen Schwellenwert, ab dem die Policy sprunghaft versagt, gibt es im untersuchten Bereich nicht. Erhöht man zusätzlich die geforderte Haltedauer an der Zielpose, verliert der Trainingsbereich nur 2,1 Prozentpunkte, das am weitesten erweiterte Szenario dagegen 7,4. Außerhalb ihrer Verteilung erreicht die Policy die Zielpose also nicht nur seltener, sie hält das Objekt dort auch weniger stabil.
Die Breite der Randomisierung
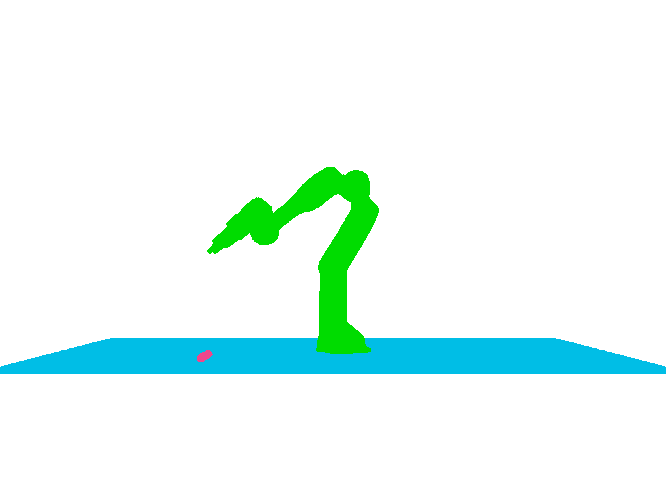
Für den zweiten Teil brauchte ich Bilder mit pixelgenauen Masken. Die entstehen aus dem laufenden Greifzyklus. Die trainierte Policy steuert den Arm, die Kamerasensorik liefert in festen Abständen das gerenderte Bild samt Maske, und der wahre Greifzustand kommt direkt aus dem Physikzustand und nicht aus irgendeiner Vorhersage. Weil eine gute Policy kaum noch Fehlgriffe produziert, habe ich sie gezielt provoziert. In einem Teil der Episoden reißt der Greifer mitten im Transport auf, in einem anderen schließt er ins Leere.
Randomisiert wurden Lichtfarbe und -intensität, Lichteinfall, Hintergrund- und Objekthelligkeit, laterale Objektpose und Kamerawinkel. Davon gibt es drei Profile, eine schwache und eine starke Trainingsstufe sowie ein Prüfprofil, dessen Wertebereiche auf sechs der sieben Achsen vollständig außerhalb beider Trainingsstufen liegen. Je Stufe habe ich fünf U-Net-Modelle mit unterschiedlichen Zufallsstartwerten trainiert, sonst wäre nicht zu trennen, was am Datensatz liegt und was an der Initialisierung.
Dieselbe Aufnahme, zehnmal vorhergesagt. Oben die fünf schwach randomisierten Modelle, darunter die fünf stark randomisierten. Beide Gruppen teilen Architektur, Trainingsverfahren und Hyperparameter, unterschiedlich ist allein die Breite der Trainingsverteilung.
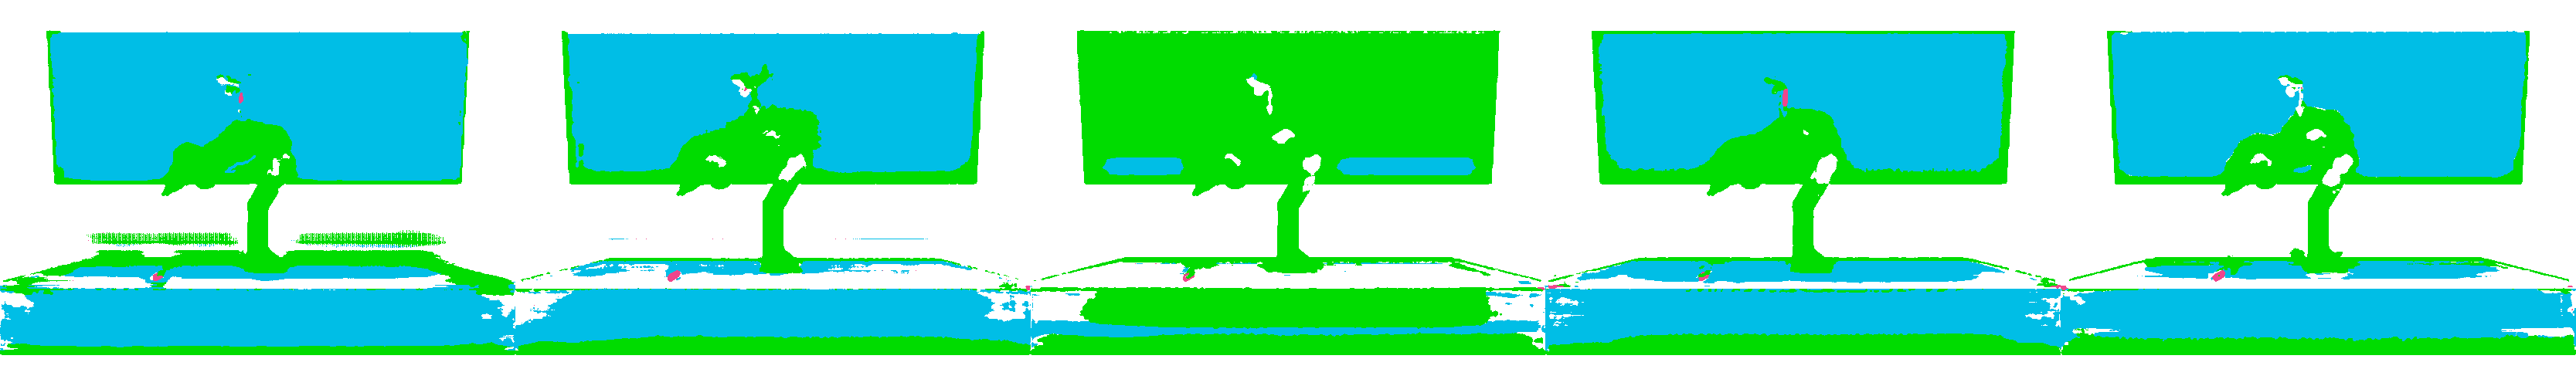
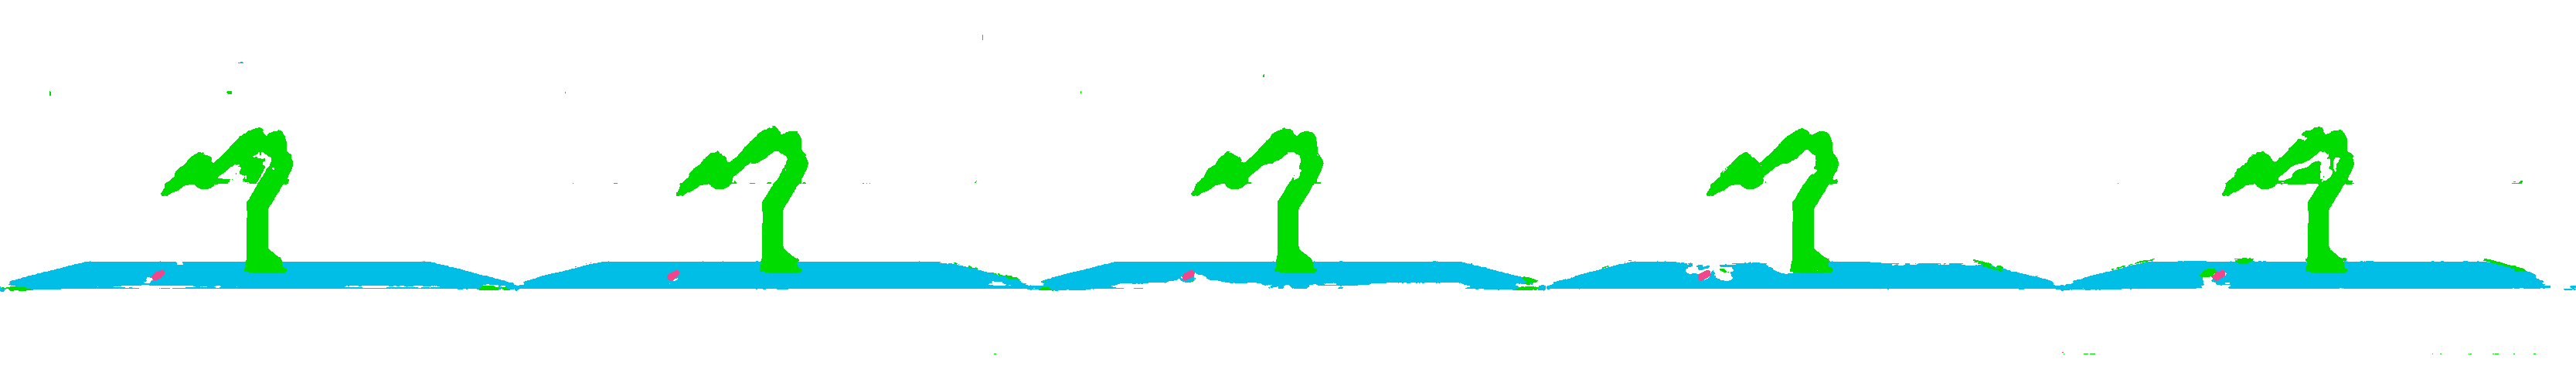
Auf der eigenen Verteilung kostet die breite Randomisierung 0,0101 mIoU. Auf dem Prüfdatensatz trennen beide Stufen 0,5523. Die schwach randomisierten Modelle werden dort nicht ungenauer, sie brechen zusammen. Ihre Pixelgenauigkeit fällt auf 0,3626 und damit unter das, was schon eine Vorhersage von reinem Hintergrund erreichen würde.
Auffällig ist auch die Streuung. Bei der schwachen Stufe reicht die mIoU der fünf Modelle von 0,1251 bis 0,2709, bei der starken von 0,7106 bis 0,7928. Die schmale Trainingsverteilung erzeugt also nicht nur schlechtere, sondern auch untereinander schlechter vergleichbare Modelle. Aus dem Validierungsverlauf ist dabei nicht abzulesen, welches Modell später versagen wird, beide Stufen enden auf demselben Niveau.
Beides zusammen
Im dritten Teil läuft die Segmentierung während der Simulation mit. Aus der vorhergesagten Maske leitet eine geometrische Regel ab, ob das Objekt getragen wird, und dieser Wert wird mit dem tatsächlichen Zustand aus der Physik verglichen, je Bedingung über 8.000 Bilder. Damit ein schlechter Wert nicht pauschal dem Netz angelastet wird, läuft dieselbe Regel zusätzlich auf der exakten Maske. Das ist die Referenz, also das Beste, was bei fehlerfreier Segmentierung überhaupt möglich wäre.
Unter kalibrierten Bedingungen erreichen beide Stufen einen F1-Wert von etwa 0,94 bei einer Referenz von 0,9548, die Segmentierung arbeitet dort praktisch verlustfrei. Unter dem Prüfprofil fällt die starke Stufe auf 0,7831 und die schwache auf 0,3320, während die Referenz mit 0,9360 fast unverändert bleibt. Der Einbruch liegt also an der Wahrnehmung, nicht an der Regel.
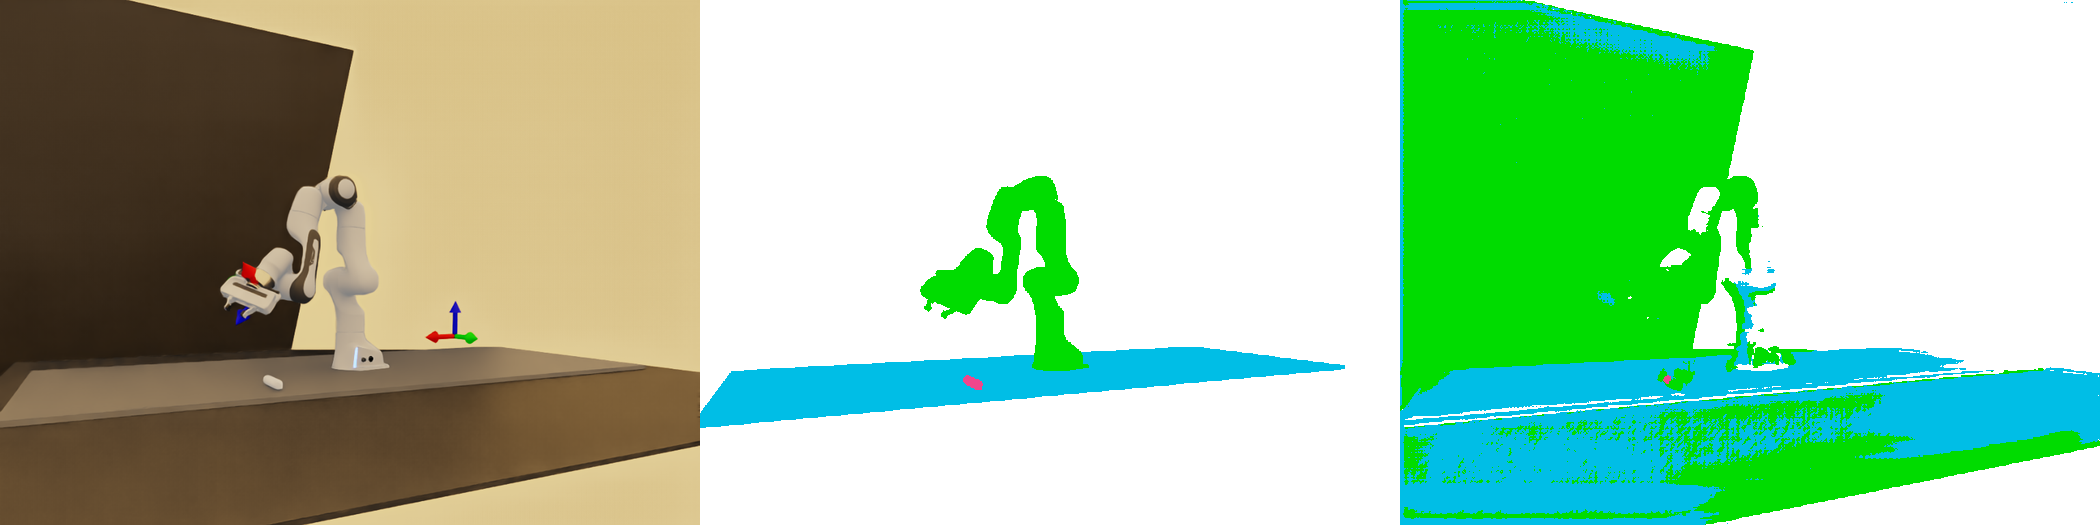
Das Objekt macht je nach Aufnahme nur 0,03 bis 0,05 Prozent aller Bildpunkte aus, in der Maske oben ist es die kleine rosa Fläche. Deshalb kombiniert die Verlustfunktion einen Dice-Anteil mit gewichteter Kreuzentropie, eine reine Kreuzentropie würde vom Hintergrund dominiert.
Gegen die Instabilität unter fremden Bedingungen habe ich zwei Maßnahmen geprüft, die ohne erneutes Training auskommen. Ein Ensemble der fünf Modelle einer Stufe hebt den F1-Wert um 0,067, eine zeitliche Glättung über aufeinanderfolgende Bilder um weitere 0,036, zusammen auf 0,8859 und damit auf 95 Prozent der Referenz. Die Glättung hilft allerdings nur dort, wo die Erkennung tatsächlich schwankt. Wo sie bereits stabil ist, verschmiert sie die echten Zustandswechsel an den Phasenübergängen.
Erkenntnisse
- Die Greifpolicy verliert außerhalb ihrer Trainingsverteilung kontinuierlich an Leistung, von 95,6 auf 78,0 Prozent, ohne erkennbaren Kipppunkt. Der Verlust ist gutmütig, aber er ist da.
- Über Erfolg und Zusammenbruch des Segmentierungsmodells entscheidet die Breite der Trainingsverteilung, nicht das Modell. Breit zu randomisieren kostet auf der eigenen Verteilung fast nichts und bringt auf unbekannten Bedingungen alles.
- Ein Gesamtwert je Modell verdeckt zu viel. Erst die Aufschlüsselung nach Greifphase zeigte, dass der schwächste Punkt der Pipeline nicht gelernt, sondern geometrisch bedingt ist.
- Tragend waren drei methodische Entscheidungen. Die Labels stammen aus dem Physikzustand und nicht aus dem zu bewertenden Modell, dieselbe Ableitungsregel läuft zusätzlich auf der exakten Maske als Referenz, und jedes Training wurde mit fünf Startwerten wiederholt. Ohne diese Referenz wäre eine geometrisch bedingte Schwäche fälschlich dem Netz zugeschrieben worden.
- Offen bleibt die Übertragung auf reale Hardware. Alle Aussagen sind simulationsintern gewonnen und gegen einen ebenfalls synthetischen Prüfdatensatz gemessen.
Die Simulationsumgebung baut auf der öffentlich verfügbaren Beispielumgebung
Isaac-Lift-Cube-Franka-v0 von NVIDIA auf. Der Quellcode liegt aus
urheberrechtlichen Gründen nicht öffentlich vor. Die vollständige Arbeit und Einblick
in das Repository stelle ich auf Anfrage zur Verfügung, die Kontaktangaben stehen auf
der Startseite.