Felix Pfarr

Würzburg · verfügbar ab sofort

Felix Pfarr

B.Sc. Data Science, zwei Jahre Werkstudent im Software Asset Management. Ich baue Datenstrecken zu Ende, von der App, die die Daten erzeugt, über Schnittstelle und Datenbank bis zum Modell, das etwas daraus macht. Betrieben wird das Ganze auf Hardware, die ich selbst administriere.

Projekte ansehen Kontakt

Werdegang

  1. seit Sep. 2024

    Werkstudent, Software Asset Management

    Vanderlande Industries

    Verantwortlich für die wiederkehrenden Reportings im Software Asset Management, die Fachbereichen und Management als Entscheidungsgrundlage dienen. Der Schwerpunkt liegt auf der Datenbasis dahinter. Bestände aus mehreren Quellsystemen führe ich zusammen, bereinige sie und prüfe sie auf Konsistenz, bevor daraus Kennzahlen werden.

    • Aufbau und Weiterentwicklung wiederkehrender Reportings
    • Datenaufbereitung und Qualitätssicherung großer Bestände
    • Automatisierung der Aufbereitungs- und Auswertungsschritte mit Python
  2. Apr. 2023 – Sep. 2026

    B.Sc. Data Science

    AKAD University Stuttgart

    Fernstudium berufsbegleitend. Fachlicher Schwerpunkt auf maschinellem Lernen und Datenanalyse, ergänzt um Data Engineering und Softwareentwicklung.

    • Wahlvertiefungen in visueller und allgemeiner Datenanalyse sowie maschinellem Lernen
    • Bachelorarbeit über Reinforcement Learning und Bildsegmentierung in der Robotersimulation
    • Studienleistungen abgeschlossen mit einem Durchschnitt von 1,6, Gesamtnote nach Bewertung der Bachelorarbeit

Projekte

Selbst gehostete Datenplattform

privat · laufend

Ein privates System, das ich vollständig selbst betreibe. Es sammelt, was ich an einem Tag esse, wie ich mich fühle, was ich tue, wie meine Vitalwerte aussehen und wie die Luft in dem Raum ist, in dem ich gerade sitze. Ziel ist es, Zusammenhänge sichtbar zu machen, die ohne durchgehende Messung unsichtbar bleiben, etwa zwischen Sport am Vortag und der Stimmung oder zwischen Luftqualität und Konzentration.

Kern ist eine Django Anwendung, die Ernährung und Kalorien pro Tag erfasst und gleichzeitig als REST-Schnittstelle für alles andere dient. Zwei selbst gebaute Flutter Apps schicken Stimmung und Aktivitäten dorthin. Im Raum hängen ESP32-Boards mit BME680-Sensoren für Temperatur, Luftfeuchte, Luftdruck und Luftqualität. An jeder Tür klebt ein NFC-Tag. Einmal mit dem Handy scannen, und ein Aufruf der Schnittstelle startet die Sitzung für den Raum, in dem ich mich aufhalte. Die Vitaldaten meiner Fitbit Inspire 3 holt ein eigener Import über die Google Health API dazu.

Die Rohdaten landen in MySQL. Apache Airflow DAGs räumen sie auf, bringen die sehr unterschiedlichen Quellen in ein gemeinsames Format und legen ML-fähige Datensätze ab. Modelliert wird in einer Anaconda-Umgebung mit TensorFlow und scikit-learn.

Der Betrieb gehört zum Projekt dazu. Alles läuft auf einem Proxmox Hypervisor bei mir zu Hause, aufgeteilt auf getrennte Ubuntu Server VMs für die Django Anwendung, die MySQL Datenbanken und die Analyseumgebung. Virtualisierung, Netzwerk, Nutzerrechte, Backups und Updates liegen damit genauso bei mir wie der Code.

  • Django
  • REST-API
  • Flutter
  • ESP32 / BME680
  • NFC
  • Google Health API
  • MySQL
  • Apache Airflow
  • TensorFlow
  • scikit-learn
  • Proxmox
  • Virtualisierung
  • Ubuntu Server
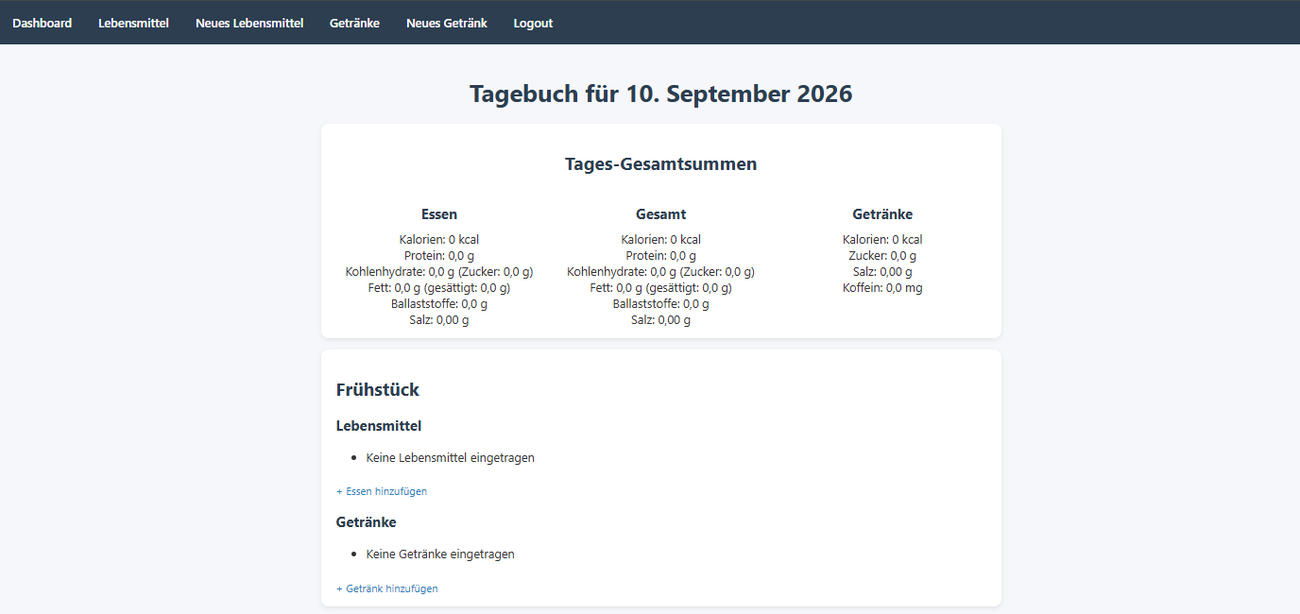
Tagebuchansicht der Django-Anwendung mit Tages-Gesamtsummen für Essen, Getränke und Gesamt
Tagesansicht der Django Anwendung
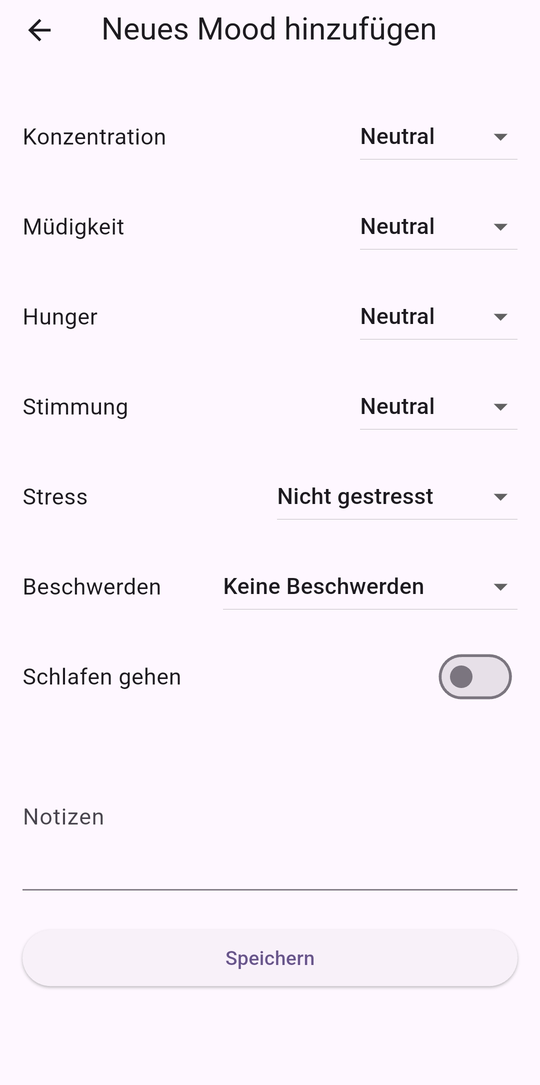
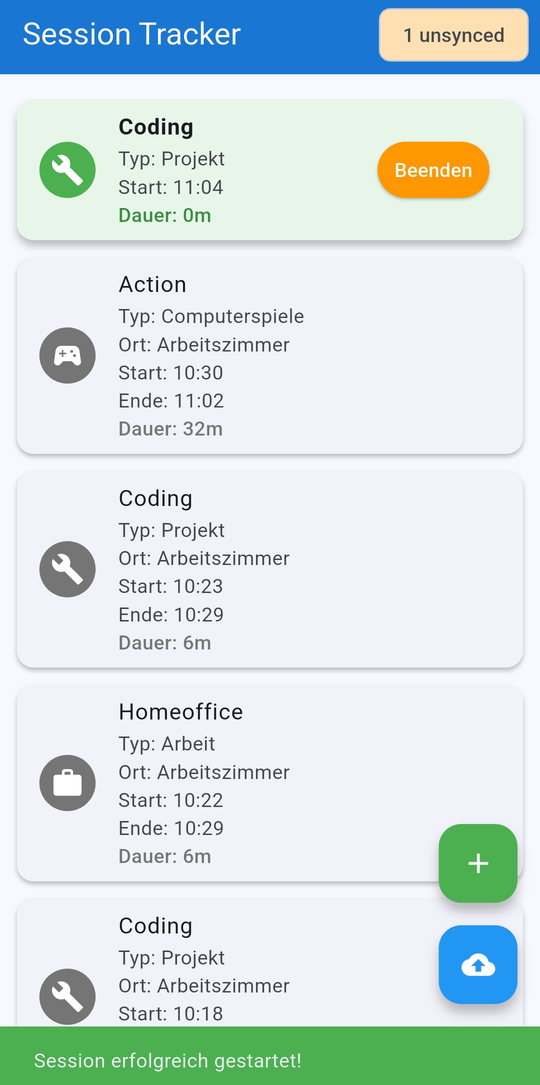
Eingabemaske der Flutter-App für die Stimmung mit Auswahlfeldern für Konzentration, Müdigkeit, Hunger, Stimmung und Stress Flutter-App für Aktivitäten mit einer laufenden Session und den zuletzt beendeten Sessions
Die beiden Flutter Apps
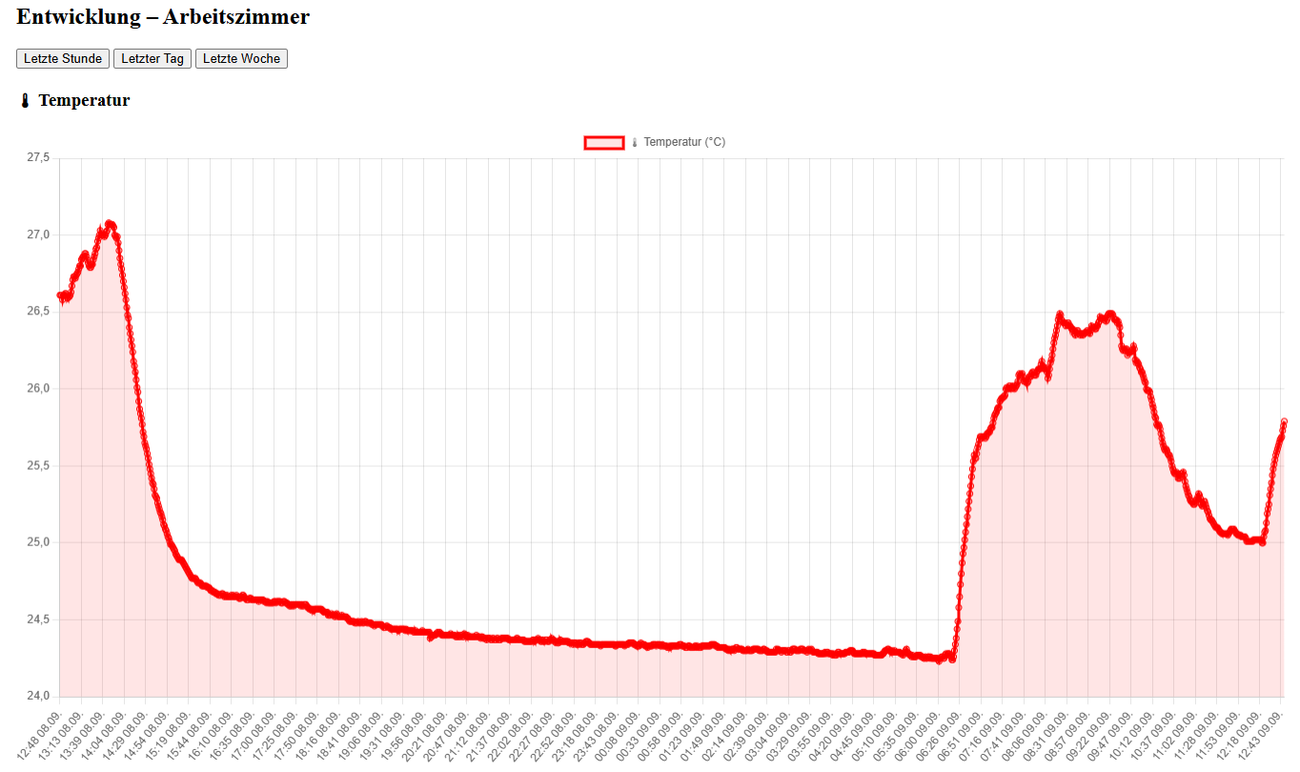
Temperaturverlauf im Arbeitszimmer über 24 Stunden aus den Messwerten des ESP32
Temperaturverlauf im Arbeitszimmer

Vom Sensor bis zum Modell, in vier Schritten.

KI-gestützte Roboter-Manipulationspipeline

Bachelorthesis · AKAD University Stuttgart · 2026

Ein Franka-Emika-Panda greift ein selbst in Fusion 360 konstruiertes, chirurgisch nachempfundenes Instrument, hebt es an und legt es an einer Zielpose ab. Gelernt hat er das in NVIDIA Isaac Lab mit PPO, in 4.096 parallelen Umgebungen. Ein U-Net liest anschließend aus dem Kamerabild ab, ob das Instrument gerade getragen wird.

Untersucht habe ich nicht, ob das funktioniert, sondern was passiert, wenn sich die Bedingungen ändern. Die Greifpolicy fällt von 95,6 auf 78,0 Prozent Erfolgsrate, sobald der Bereich der Objektstartpose um 60 Prozent wächst, und zwar gleichmäßig und ohne Kipppunkt.

Beim Segmentierungsmodell entscheidet dagegen die Breite der Randomisierung über alles. Auf der eigenen Verteilung kostet sie 0,01 mIoU, unter unbekannten Bedingungen trennen die beiden Stufen 0,55. Die schmal trainierten Modelle werden dort nicht ungenauer, sie brechen zusammen. Breit zu randomisieren ist damit fast kostenlos und entscheidet trotzdem über Erfolg und Totalausfall.

  • Fusion 360
  • NVIDIA Isaac Sim
  • Isaac Lab
  • rsl_rl
  • PPO
  • Domain Randomization
  • U-Net
  • Python
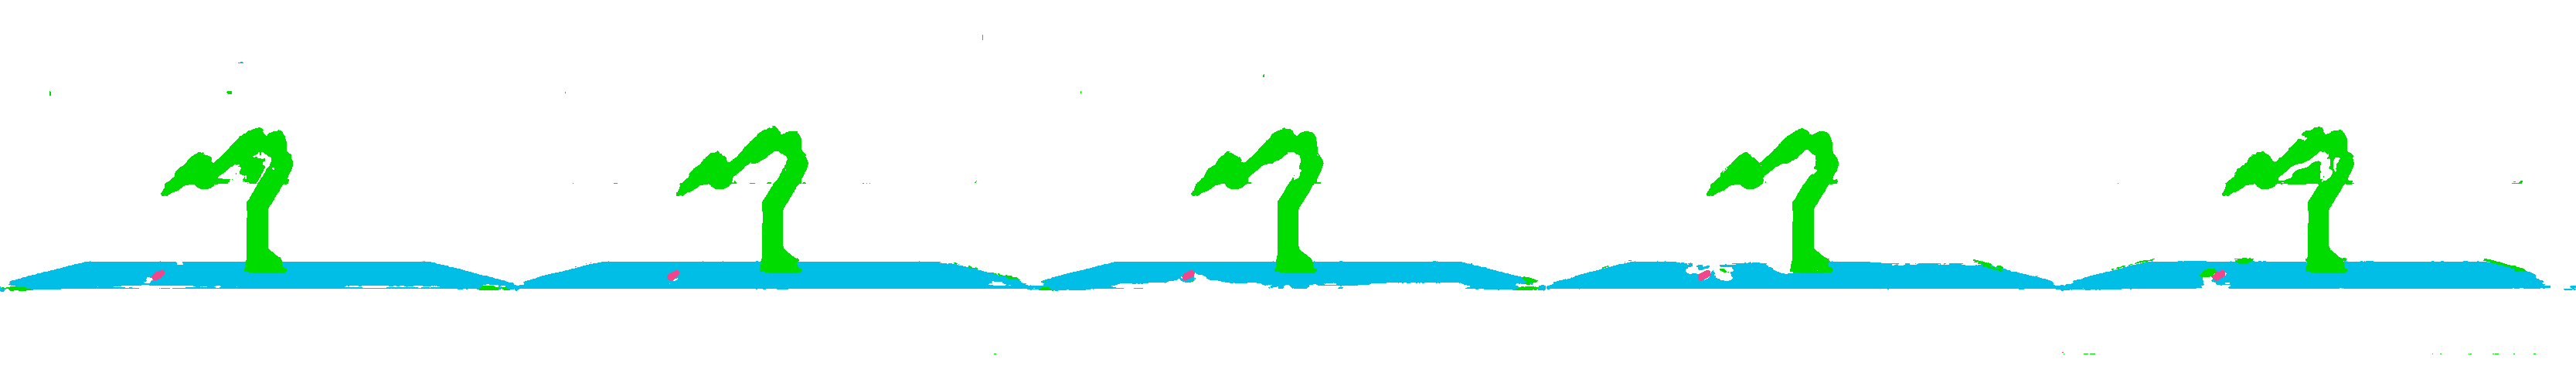
Fünf Vorhersagen stark randomisierter U-Net-Modelle auf demselben unbekannten Bild, die Roboter und Ablagefläche sauber trennen
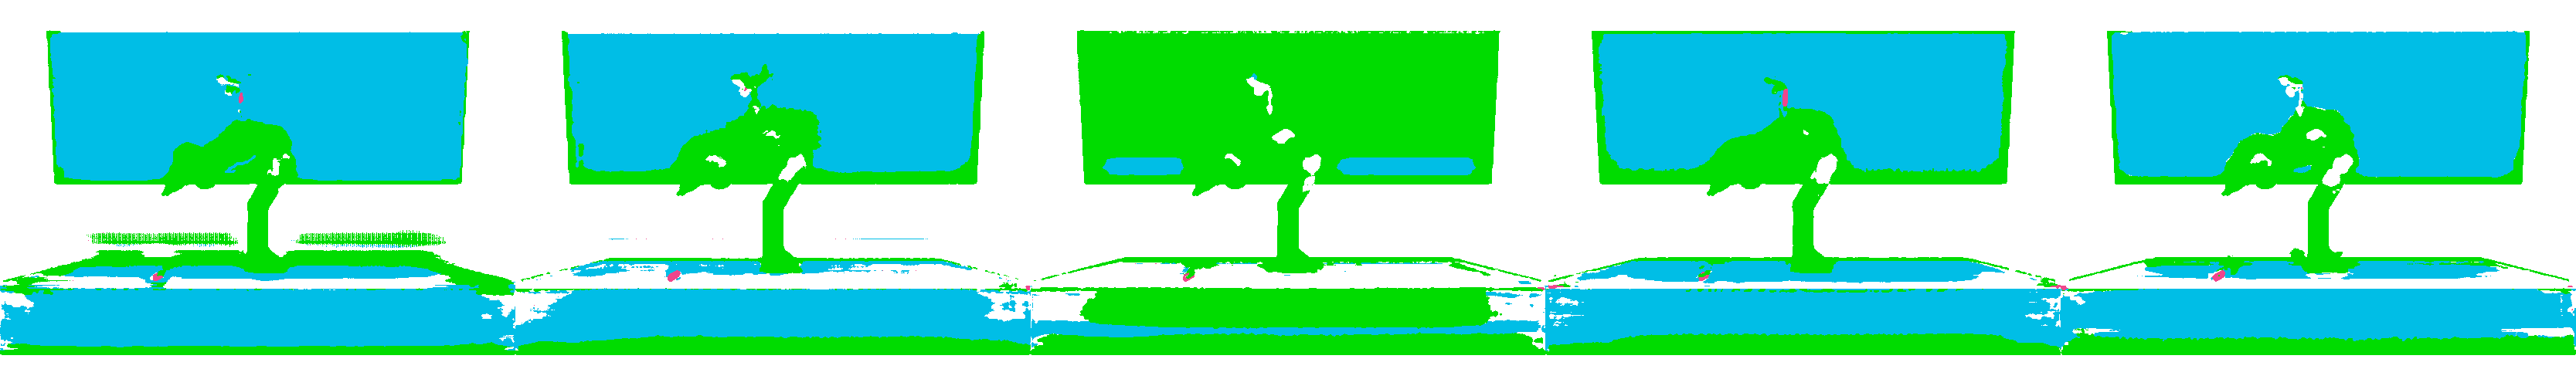
Fünf Vorhersagen schwach randomisierter U-Net-Modelle auf demselben Bild, in denen Hintergrund und Ablagefläche großflächig falsch zugeordnet werden
Ein früherer Trainingsstand, in dem der Arm beim Annähern kollabiert

Von der CAD-Datei bis zur Zustandserkennung.

Bildhochskalierung mit generativer KI

Studienprojekt · Note 1,0

Aus HAM10000 habe ich Bildpaare in 64x64 und 256x256 Pixeln erzeugt und in TensorFlow ein SRGAN gebaut, das die niedrige Auflösung wieder hochrechnet. Die eigentliche Untersuchung kam danach, denn anschließend lief derselbe Klassifikator über alle drei Varianten.

Er erreicht 71 Prozent Genauigkeit auf den niedrig aufgelösten Bildern, 74 Prozent auf den echten hochaufgelösten und 78 Prozent auf den hochskalierten. Die Rekonstruktion schlägt also das Original. Bei Melanoma, der klinisch wichtigsten Klasse, fällt die Trefferquote gleichzeitig von 0,79 auf 0,54, was die gute Gesamtzahl deutlich relativiert.

  • TensorFlow
  • SRGAN
  • VGG19
  • EfficientNetB0
  • Transfer Learning
  • OpenCV
  • HAM10000
  • Python
Niedrig aufgelöst 64 × 64 Generator 16 Residual-Blöcke 2 × Upsampling Erzeugt 256 × 256 Echtes Bild 256 × 256 Diskriminator echt oder erzeugt Rückmeldung an den Generator, zusammen mit dem perzeptuellen Verlust über ein eingefrorenes VGG19 Klassifikationsgenauigkeit auf 560 Testbildern 64 × 64 0,71 hochskaliert 0,78 256 × 256 echt 0,74
Aufbau des SRGAN und Ergebnis des Vergleichs

Der Aufbau des Experiments.

Kenntnisse

Programmierung
Python & SQL
Machine Learning & KI
TensorFlow, scikit-learn, pandas, NumPy, Matplotlib, Reinforcement Learning, NVIDIA Isaac Sim und Isaac Lab
Data Engineering
Apache Airflow, ETL- und Datenpipelines, Datenmodellierung, MySQL, Datenbereinigung und -konsolidierung
App- & Webentwicklung
Django
Infrastruktur & Betrieb
Proxmox, Virtualisierung und Hypervisor-Betrieb
Sprachen
Deutsch, Englisch (C1, verhandlungssicher)

Kontakt

Ich suche eine Einstiegsposition im Raum Würzburg, in der Datenanalyse und praktische Umsetzung zusammenkommen. Vollständige Bewerbungsunterlagen sende ich auf Anfrage zu.